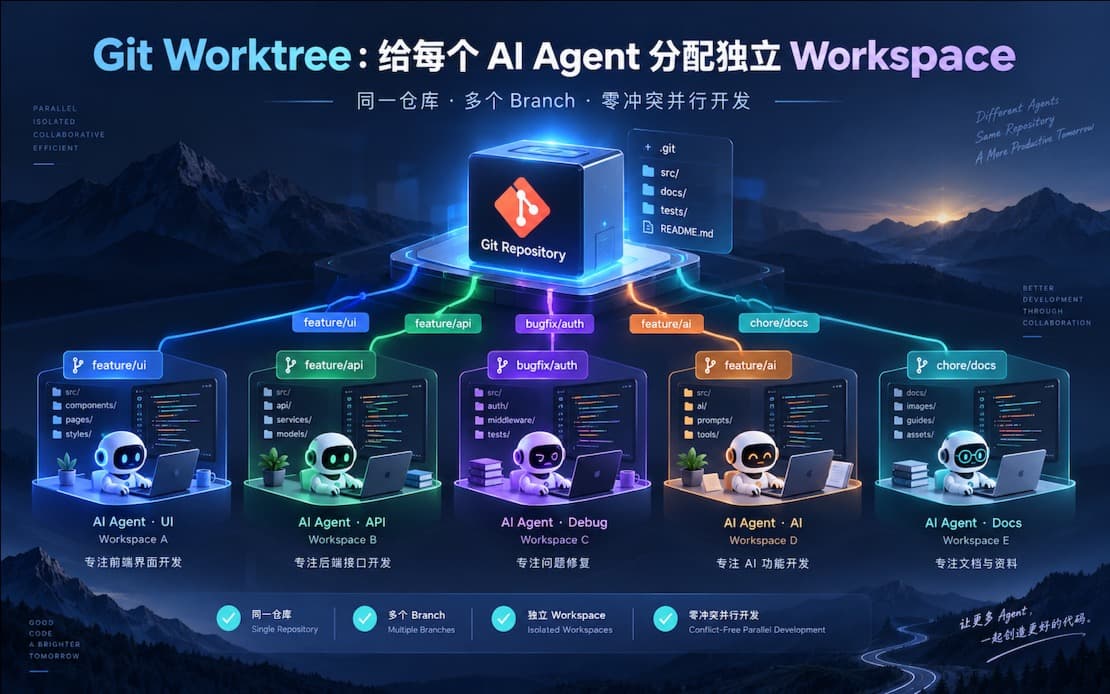
简介
大多数人用 AI 写代码,还是串行模式:等一个 Agent 跑完,review,再让下一个改。这等于把 AI 当单核 CPU 用。
结论先说:用 Git Worktree 给每个 AI 开独立的 workspace,并行跑多个 Agent,互不干扰,最后统一 merge。这是目前成本最低、配置最简单的多 AI 并行方案——不需要任何额外工具,Git 原生支持,今天就能用。
本文覆盖:完整工作流、任务拆分原则、三个必踩的坑,以及什么情况下这个方案反而是负担。
为什么不直接多开几个终端?
很多人的第一反应是:多开几个 terminal,每个 terminal 里跑一个 Claude Code,指向同一个项目目录。
这会出问题。
文件竞争:两个 Agent 同时改 src/api/user.ts,后写入的直接覆盖前一个的修改,没有任何冲突提示。
中间状态污染:Agent A 改了一半的 schema.prisma,Agent B 读到的是破损的 schema,接着在错误的基础上继续生成代码。这种问题排查成本极高,因为错误是在 Agent B 的输出里,但根源在 Agent A。
工具链冲突:pnpm install 同时跑两次,node_modules 会损坏。TypeScript language server 同时被两个进程占用,各种奇怪的类型错误随机出现。
根本原因是:同一个 working directory 本质上是共享状态,不是并发安全的。
Git Worktree 的本质
Git Worktree 解决的就是这个问题。
一句话描述:同一个 .git 仓库,挂载多个独立的文件目录,每个目录对应一个独立的 branch。
my-project/           ← 主 worktree(main branch)
  .git/               ← 唯一的 object store,所有 worktree 共享
  src/
  ...

../my-project-auth/   ← worktree 1(feat/auth branch)
  src/
  ...

../my-project-dash/   ← worktree 2(feat/dashboard branch)
  src/
  ...
和 git clone 的本质区别: 会复制整个 目录,磁盘占用翻倍,branch 之间相互独立没有感知。Worktree 共享同一个 object store,磁盘开销几乎可以忽略(只有 working directory 的文件是独立的),并且所有 worktree 的 branch 状态对主仓库完全可见。